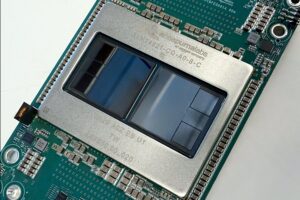
OpenAI har tatt et betydelig skritt i sin strategi for teknologisk uavhengighet med presentasjonen av de første resultatene fra sin spesialtilpassede AI-prosessor, kalt Jalapeño. Denne inferensfokuserte brikken, utviklet i samarbeid med Broadcom, har overgått Nvidia GB200- og GB300-akseleratorene på to viktige målinger: prosessorkraft per watt og responshastighet. Dataene, som ble publisert på Hot Chips-konferansen og rapportert av kanaler som Bloomberg og The Verge, posisjonerer OpenAI på en enestående måte i kappløpet om AI-maskinvare.
Dette er ingen liten kunngjøring. Frem til nå har OpenAI nesten utelukkende vært avhengig av Nvidia-prosessorer for å kjøre modellene sine, både i trenings- og inferensfasen – det vil si når systemet svarer på brukerhenvendelser. Med Jalapeño tar selskapet sikte på å redusere driftskostnadene og få kontroll over infrastrukturen sin, men uten å forlate Nvidia fullstendig. Ifølge Richard Ho, OpenAIs maskinvaresjef, tilbyr brikken det han kaller «det beste fra begge verdener»: høy kapasitet til å betjene mange klienter samtidig og lav latens for interaktive applikasjoner.

Hva er jalapeño, og hvordan fungerer det?
Jalapeño er en applikasjonsspesifikk integrert krets (ASIC), designet fra grunnen av for én enkelt oppgave: å kjøre forhåndstrente språkmodeller. I motsetning til Nvidias GPU-er, som er generelle prosessorer, er denne brikken optimalisert for inferensfasen, der systemet behandler en forespørsel og genererer et svar. Den er ikke ment for trening av modeller, en oppgave som fortsatt er domenet til Nvidias GPU-er, og som OpenAI vil fortsette å bruke til det formålet.
Brikkens design fokuserer på å redusere flaskehalser som vanligvis oppstår under inferens, for eksempel dataflyt mellom minne og databehandlingsenheter. Ifølge selskapet integrerer Jalapeño en stor databehandlingsseksjon sammen med seks HBM-blokker (high-bandwidth memory), slik at data kan holdes lokalt og unødvendige overføringer unngås. Videre kan brikken aktivere den riktige kombinasjonen av ressurser for hver behandlingsfase, noe som forbedrer både AI-ens ytelse og energieffektivitet.
Benchmark-resultater mot Nvidia
Testene ble utført ved hjelp av SemiAnalysis' offentlige InferenceX-plattform, som måler ytelsen til AI-systemer under reelle forhold. OpenAI sammenlignet Jalapeño med de beste poengsummene oppnådd av Nvidia GB200- og GB300-superbrikkene, som var de tilgjengelige referansepunktene på testtidspunktet. Resultatene viste at Jalapeño oppnår mellom 1,5 og 1,9 ganger mer AI-arbeid per watt, og en ende-til-ende-forsinkelse mellom 1,7 og 3,6 ganger lavere. Modellene som ble brukt i testserien var GPT-OSS 120B, DeepSeek R1 og Kimi K3 , en blanding av modeller med åpen vekt og frontmodeller.
Disse tallene er spesielt relevante fordi energieffektivitet har blitt en av bransjens største utfordringer. AI-datasentre forbruker enorme mengder strøm, og å redusere forbruket per arbeidsenhet kan føre til betydelige besparelser. Ifølge Richard Ho opererer Jalapeño på rundt 700 watt, et relativt lavt tall for en inferensakselerator, og kan redusere driftskostnadene med rundt 50 % sammenlignet med konvensjonelle GPU-er, ifølge Broadcom-sjef Hock Tan.
Samarbeid med Broadcom og veikart
Utviklingen av Jalapeño er et resultat av en strategisk allianse mellom OpenAI og Broadcom, annonsert i oktober 2025. Broadcom bidrar med sin ekspertise innen silisiumdesign, nettverk og produksjon, mens OpenAI har brukt sine egne AI-modeller for å akselerere designprosessen. Brikken gikk fra første design til tape-out, det siste stadiet før produksjon, på bare ni måneder – en rekordtid for en avansert halvleder.
OpenAI jobber allerede med en andre generasjon av prosessoren og har en tredje under utvikling. Selskapet planlegger å distribuere de første systemene med Jalapeño i svært små volumer innen utgangen av 2026 og utvide bruken betydelig i løpet av 2027. Ifølge Bloomberg vil distribusjonen finne sted i datasentre hos Microsoft og andre partnere, og skalaen forventes å nå 10 gigawatt datakraft innen 2029. Resultatene som presenteres er imidlertid foreløpige og har ennå ikke blitt validert i et storskala produksjonsmiljø.
Implikasjoner for markedet og brukerne
Jalapeños ankomst betyr ikke at OpenAI forlater Nvidia. Selskapet har insistert på at Nvidia fortsatt er en nøkkelpartner, spesielt for modelltrening, og at etterspørselen etter datakraft er så høy at de trenger flere leverandører. Faktisk samarbeider OpenAI også med AMD og Cerebras, og strategien deres innebærer å bygge en heterogen infrastruktur der hver arbeidsmengde er tildelt den mest effektive maskinvaren.
For brukere og utviklere har denne nyheten direkte implikasjoner. Hvis Jalapeño leverer på løftene sine, kan kostnaden per inferansetoken falle mellom 30 % og 50 % i løpet av de neste 18 månedene, slik at oppstartsbedrifter og selskaper kan tilby rimeligere AI-tjenester med lavere latens. Videre intensiveres konkurransen i AI-brikkemarkedet, noe som kan føre til bedre priser og flere alternativer for sluttbrukere.
Til slutt er det verdt å merke seg at testene ikke inkluderte en sammenligning med Nvidias nye Vera Rubin-arkitektur, som nylig har blitt levert. Derfor kan Jalapeños fortrinn forringes når Nvidia slipper sin neste generasjon. Likevel viser OpenAIs fremgang at AI-bransjen går inn i en ny fase, der tilpasset maskinvare vil spille en stadig viktigere rolle. Kappløpet om effektivitet og hastighet har bare så vidt begynt.