Hvis du er lei av at månedlige abonnementer tapper lommeboken din, eller at tokengrenser ødelegger momentumet ditt akkurat når du er på ditt beste, er du ikke alene. Å sette opp ditt eget lokale AI-miljø er den ultimate løsningen for å gjenvinne kontrollen, beskytte koden din og slutte å stole på lunene til skyservere.
For de som begir seg ut i dette feltet, spesielt med kraftige maskiner som den nye Mac mini M4, kan økosystemet virke som en labyrint. Nøkkelen er imidlertid å forstå at du ikke trenger et eneste magisk verktøy, men snarere å sette sammen en stabel bestående av en inferensmotor, en spesialisert kodemodell og et grensesnitt som fungerer som en autonom agent.
Søylene til en lokal kodeassistent
For å få alt til å fungere uten å måtte kopiere og lime inn kodebiter som en gal, trenger du fire veldefinerte lag. Først er kjøretids- eller utførelsesmiljøet , der Ollama og LM Studio for tiden regjerer suverent på grunn av deres brukervennlighet i å servere modeller via OpenAI-kompatible API-er. Deretter kommer språkmodellen (LLM) , som er hjernen som resonnerer; her har Qwen2.5-Coder-familien blitt gullstandarden for sin balanse mellom størrelse og kapasitet.
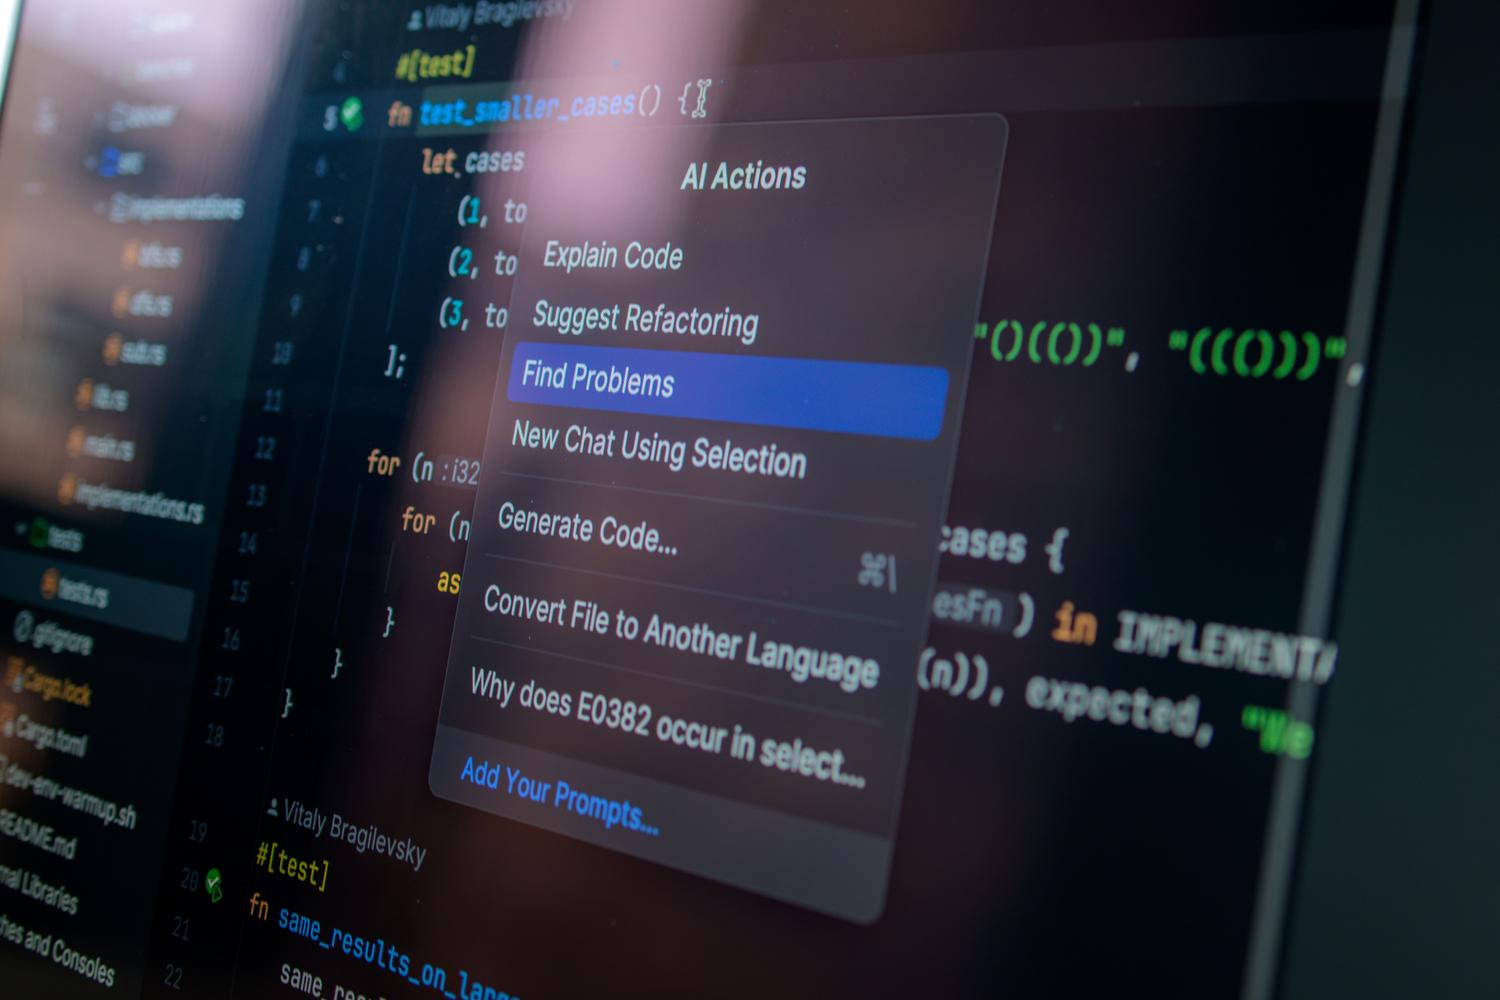
Den tredje delen er IDE-klienten eller -grensesnittet , for eksempel Continue-utvidelsen for VS Code, som tilbyr autofullføring og integrert chat. Til slutt finnes det handlingsagenter , som er mer avanserte verktøy som Cline eller Aider, som er i stand til å lese hele filer, utføre kommandoer i terminalen og foreslå faktiske endringer i depotet under din veiledning.
Anbefalte modeller basert på maskinvaren din
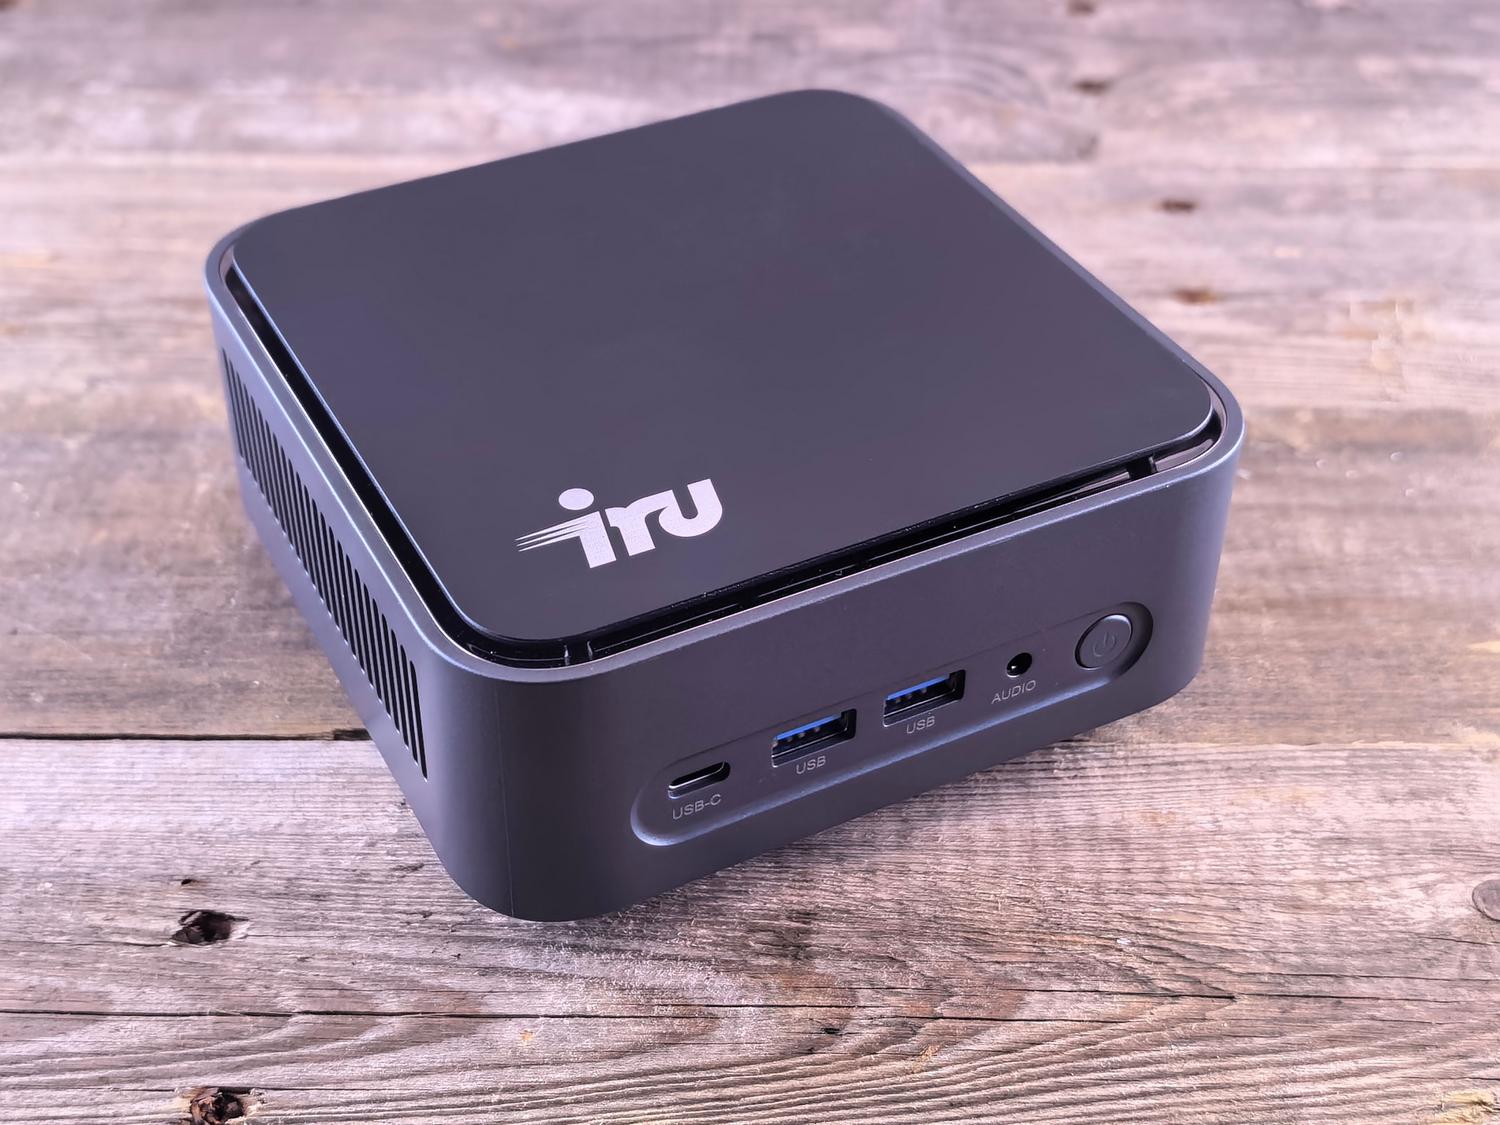
Ikke alle modeller passer til alle maskiner. Den gylne regelen er at enhetlig minne, eller VRAM , er den virkelige flaskehalsen, mye mer enn prosessorens råkraft. Hvis du har en grunnleggende datamaskin med 16 GB RAM, er 7 GB eller 8 GB-modeller det beste alternativet for raske oppgaver og lett prat.
- Qwen2.5-koder 1.5B: Ideell for umiddelbar autofullføring (tabulator-autofullføring) uten å gjøre datamaskinen tregere.
- Qwen2.5-koder 7B/14B: Det perfekte valget for de som søker en balanse mellom fart og logisk resonnement.
- Qwen2.5-koder 32B: For de med 24 GB VRAM eller mer som trenger en seriøs og profesjonell koding som nærmer seg kvaliteten til kommersielle modeller.
- DeepSeek-Coder-V2 Lite: Et brutalt alternativ for tunge logikkoppgaver eller komplekse algoritmer.
Verktøy og agenter: Hvilke skal man velge?
Avhengig av hvor mye autonomi du ønsker å gi AI-en, har du flere alternativer. Hvis du foretrekker noe integrert i editoren, er Continue det perfekte utgangspunktet. Hvis du leter etter en agent som automatisk kan redigere flere filer og administrere Git-commits, er Aider det ultimate terminalverktøyet, ettersom det optimaliserer tokenbruk gjennom repository-kart.
På den annen side har vi Goose , en svært allsidig åpen kildekode-agent som kan samhandle med filsystemet og utvides via MCP-servere. For de som søker noe mer visuelt, tillater AnythingLLM lokal kunnskapshåndtering og dokumentindeksering, selv om det er mer et produktivitetsverktøy enn en ren utvikler. Det finnes også nye prosjekter som OllamaCode , som fokuserer på å gjøre det mulig for AI ikke bare å skrive kode, men også å kjøre og teste den i sanntid.
Steg-for-steg-oppsett for en effektiv arbeidsflyt
For å få alt til å fungere perfekt, er det ideelle å starte med å installere Ollama og laste ned modellen som passer best til minnet ditt (for eksempel, ollama pull qwen2.5-coder:14bNår modellen svarer riktig på konsollen, kobler vi den til VS Code ved hjelp av utvidelsen Fortsettkonfigurere localhost-URL-en slik at chat og redigeringer skjer på din egen maskin.
Hvis du vil ta ting til neste nivå, kan du installere Cline for å ha en agent som foreslår endringer i skallet og filene, og alltid ber om din tillatelse før noe utføres. For en mer robust arbeidsflyt vil bruk av Aider tillate deg å utføre refaktorering av flere filer med utrolig nøyaktighet, og dra nytte av agentens forståelse av Git-strukturen din.
Personvern, kostnader og ytelse
Den største fordelen med denne tilnærmingen er absolutt personvern ; forretningshemmelighetene og API-nøklene dine reiser aldri til noen ekstern server, noe som er viktig hvis du jobber i regulerte sektorer. Dessuten, når du først har investert i maskinvaren, er kostnaden per token bokstavelig talt null, noe som eliminerer frustrasjonen over bruksgrenser i Cloud Pro-versjoner.
Når det gjelder ytelse, synker latensen dramatisk siden det ikke er noen rundturer på tvers av nettverket. Vær imidlertid forsiktig med KV-cachen . Hvis du merker at AI-en plutselig treger seg, har du sannsynligvis gått tom for VRAM, og systemet bruker vanlig RAM, som er mye tregere. Løsningen er å redusere kontekststørrelsen eller bruke en mindre modell.
Tips for å ikke ødelegge prosjektet
Det kan være farlig å gi terminalnøklene dine til en AI uten tilsyn. Den smarteste tilnærmingen er å bruke et restriktivt tillatelsesprinsipp : la AI-en lese filene først, deretter foreslå en plan, og først deretter skrive endringene. Tillat aldri en agent å utføre kommandoer for å slette filer eller utføre masseinstallasjoner uten først å bekrefte den nøyaktige kommandoen.
Det anbefales å jobbe i dedikerte Git-grener for AI-testing. På denne måten, hvis agenten bestemmer seg for å refaktorere og ødelegger hele prosjektet, kan du gå tilbake til én enkelt kommando. Den vinnende tilnærmingen er: lite mål, kontekstinspeksjon, godkjenning av en begrenset patch og validering med ekte tester før den endelige commiten foretas.
Kombinasjonen av en runtime som Ollama, kraftige modeller i Qwen-serien og autonome agenter som Aider eller Cline forvandler en personlig datamaskin til en selvstendig utviklingsarbeidsstasjon. Ved å prioritere enhetlig minne og administrere utførelsestillatelser kan enhver programmerer eliminere avhengigheten av skykvoter og nyte en smidig, privat og helt gratis arbeidsflyt.